Andrej Karpathy, investigador de Inteligencia Artificial y miembro fundador de OpenAI, advirtió que se amplía la brecha entre las experiencias de quienes usan modelos de lenguaje. En una publicación en X, describió un embudo con cuatro niveles, desde personas con escaso contacto con estas herramientas hasta un grupo reducido con acceso a sistemas internos de laboratorios.
“La brecha en la comprensión compartida de las capacidades de los modelos de lenguaje se está ampliando”, escribió. Su planteamiento distingue el uso ocasional de chatbots de las tareas técnicas realizadas con modelos avanzados. Los modelos de lenguaje son sistemas que generan y procesan texto, como los que emplean asistentes conversacionales.
Karpathy presentó las cantidades como cálculos informales. Su clasificación combina frecuencia de uso, actividad profesional y nivel de acceso; las proporciones son aproximadas y carecen de una metodología estadística publicada. El investigador, que también dirigió el área de IA de Tesla, retomó una reflexión anterior sobre las diferencias entre usuarios.
Los cuatro niveles que describió Andrej Karpathy
El primer grupo reúne, según su estimación, a unos 6.000 millones de personas, cerca del 75% de la población, que apenas entraron en contacto con estos modelos. El siguiente incluye entre 1.000 y 2.000 millones, alrededor del 20%, que utilizan ocasionalmente productos gratuitos similares a ChatGPT.
Para esos usuarios, señaló, el chatbot suele funcionar como una búsqueda mejorada o una ayuda para escribir. También ubicó en ese nivel a numerosos profesionales ajenos a las matemáticas y la programación. Incluyó a ejecutivos cuyas tareas se concentran en conversar con otras personas y cuya exposición a los avances sigue siendo indirecta.
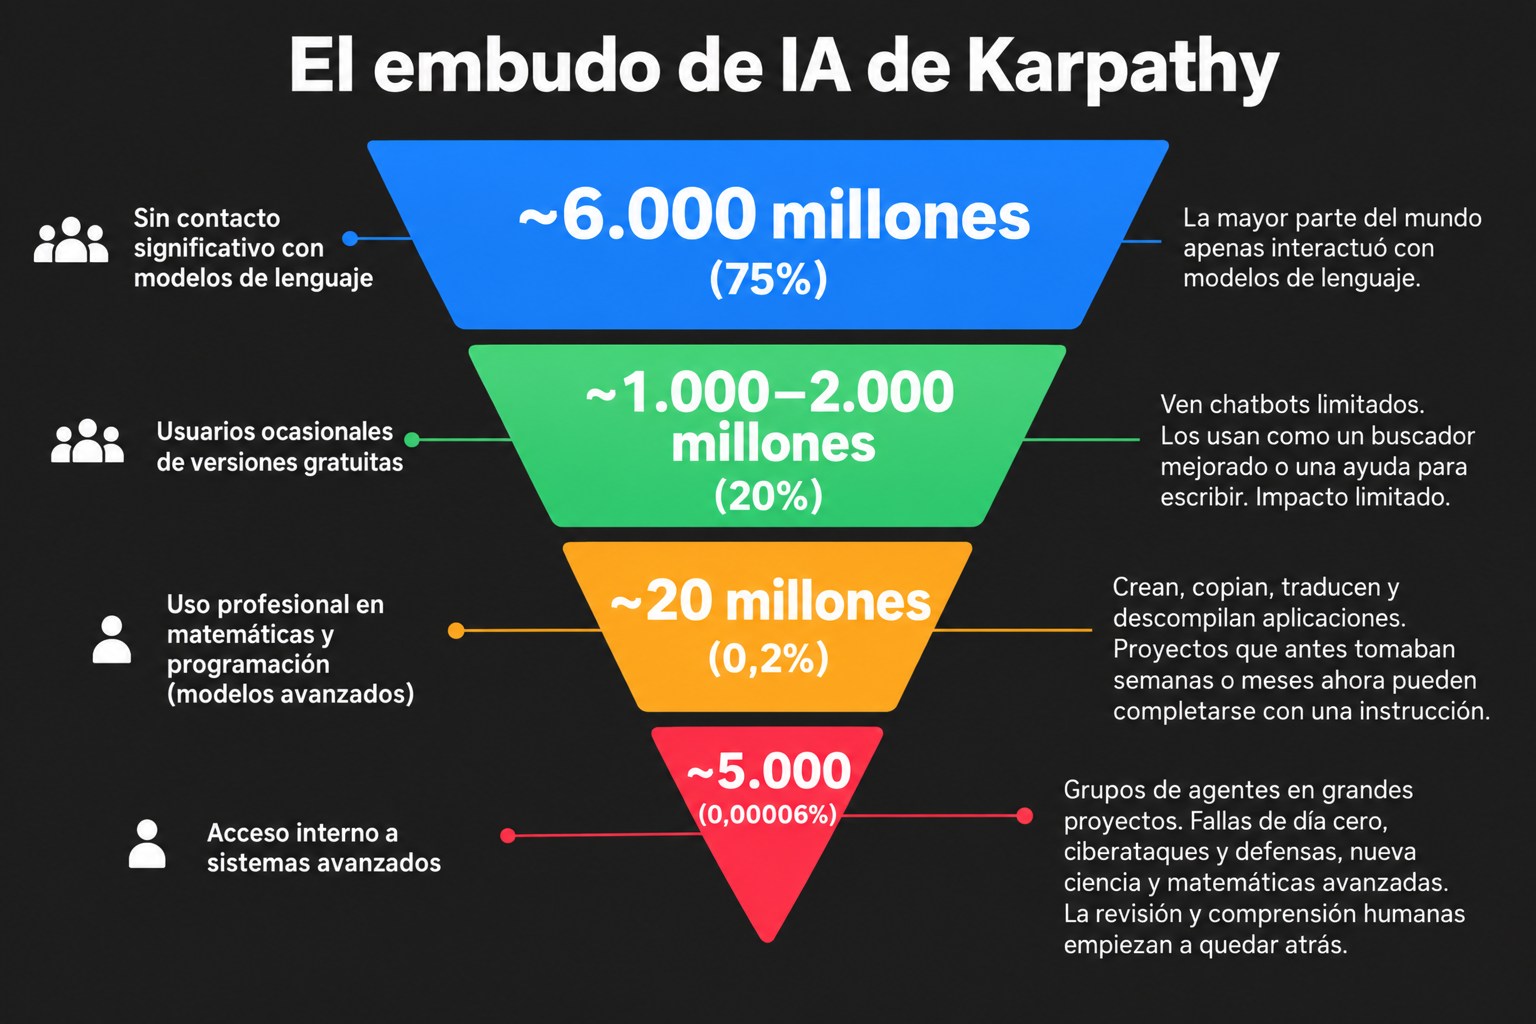
El tercer nivel comprende unos 20 millones de profesionales, aproximadamente el 0,2%, que emplean modelos avanzados en matemáticas y código. Karpathy afirmó que esos usuarios observan cómo los agentes de IA, sistemas que ejecutan tareas con herramientas informáticas, completan proyectos que antes requerían semanas o meses.
En el extremo más estrecho situó a unas 5.000 personas con acceso interno a sistemas avanzados. Describió grupos de agentes que trabajan durante semanas en grandes proyectos de software, ciberseguridad e investigación. Atribuyó a ese entorno tareas cuya revisión humana resulta cada vez más difícil de seguir al mismo ritmo.
El tipo de tarea y el acceso cambian la experiencia
En su reflexión anterior, Karpathy sostuvo que la impresión de muchos usuarios se formó con versiones gratuitas y antiguas. Contrastó los errores visibles en consultas simples con avances técnicos que asociaba a herramientas como Claude Code y los asistentes de programación de OpenAI. Señaló que pagar por un modelo avanzado tampoco iguala la experiencia de todas las profesiones.
Para explicar esa diferencia, vinculó los avances en código y matemáticas con el aprendizaje por refuerzo, un método de entrenamiento que recompensa resultados evaluables. En programación, por ejemplo, una prueba automática permite comprobar si una solución funciona. Evaluar la calidad de un texto admite criterios menos definidos, un contraste que utilizó para explicar el desempeño desigual entre tareas.
También atribuyó la concentración de mejoras a los incentivos económicos de las empresas. Según su análisis, los usos técnicos ofrecen oportunidades comerciales que influyen en las prioridades de desarrollo. A ese factor sumó la escala del problema. Una consulta breve exige menos al sistema que un proyecto complejo sostenido durante más tiempo.
El acceso completa su explicación. Diferenció los planes gratuitos, los servicios de pago y los sistemas internos. En su planteamiento, esas condiciones coexisten con usos muy distintos, por lo que una experiencia con un chatbot para buscar información ofrece una referencia diferente a la de un profesional que lo utiliza para construir software.