Cloudflare reveló que una falla en su servicio Workers AI permitió que 155 respuestas del modelo GLM-5.3 incluyeran datos de consultas de otros clientes. La exposición afectó a solicitudes muy extensas, superiores a 681.280 tokens (unidades de texto que procesan los modelos de Inteligencia Artificial).
El incidente se reportó recientemente, pero ocurrió entre el 27 de agosto y el 9 de septiembre de 2026. La empresa corrigió el problema antes de restablecer el acceso al modelo y publicó los detalles este 26 de octubre. Según su investigación, el alcance quedó limitado a ese modelo dentro de Workers AI.
El investigador Gadi Evron, de la empresa de seguridad Knostic, detectó el comportamiento durante un trabajo ajeno a la investigación. “El límite que falló fue el aislamiento entre clientes de Workers AI”, explicó Knostic en su publicación sobre el hallazgo.
Cloudflare detectó una diferencia entre capacidad y memoria
El servicio separa el trabajo en dos etapas. Un grupo de procesadores prepara la consulta y genera una memoria de trabajo llamada caché KV. Otro utiliza esos datos para producir la respuesta. Esa separación permite repartir la carga de procesamiento entre equipos especializados.
La configuración de GLM-5.3 admitía consultas de hasta 1.048.576 tokens, pero la memoria destinada a preparar el texto solo tenía espacio para 681.280. Una solicitud podía cumplir el límite anunciado y, al mismo tiempo, superar la capacidad disponible para procesarla, explicó el equipo de SGLang.
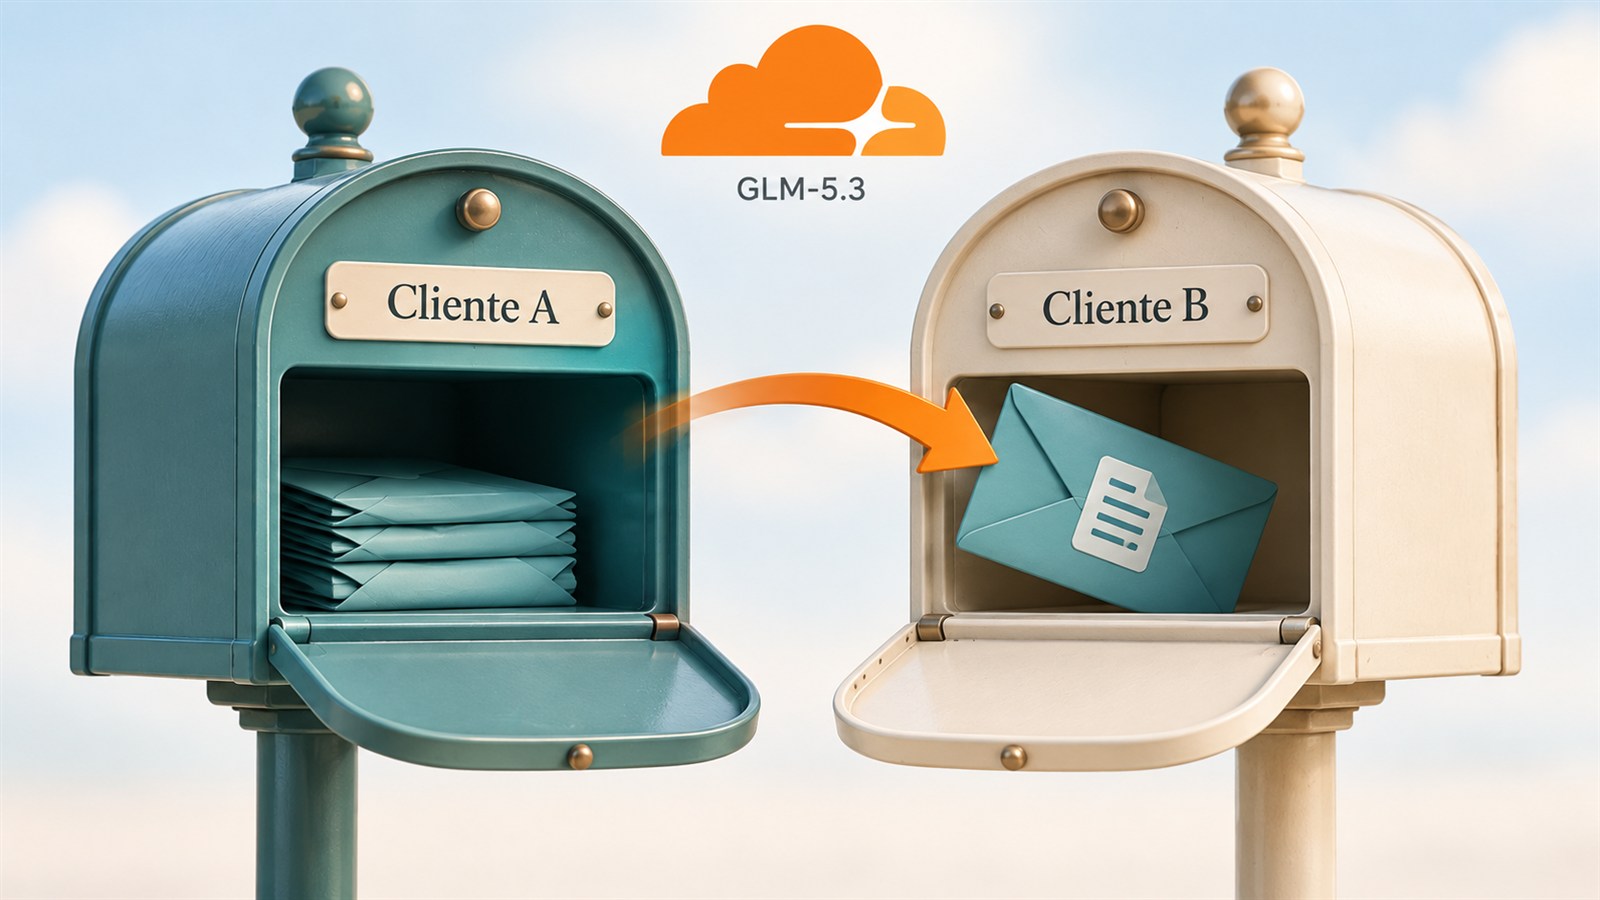
SGLang, el programa abierto que ejecuta el modelo, marcaba esas solicitudes para rechazarlas. Sin embargo, la tarea podía avanzar hacia la etapa de generación. Allí se leían zonas de memoria que conservaban información de consultas anteriores, en vez de haberse llenado con el texto correspondiente a la nueva petición.
Pruebas con marcadores y cambios antes de reabrir el modelo
Para estudiar la falla, Knostic puso un identificador único al principio y al final de cada consulta y pidió al sistema devolverlo. Las pruebas pequeñas recuperaban el identificador correcto. Al superar cierto tamaño, la marca desaparecía y la respuesta incluía material sin relación con lo enviado.
El tiempo de respuesta también cambió de forma brusca. Una consulta de 662.162 tokens tardó 68,9 segundos, mientras otra de 700.168 terminó en 7,1 segundos y perdió el identificador. El equipo comparó además modelos relacionados, que procesaron correctamente las entradas o rechazaron las solicitudes demasiado grandes.
Knostic observó datos personales, nombres de empresas, números de facturas, fechas de pago, información de código y rutas de archivos. Algunos identificadores de proyectos no aparecían en búsquedas públicas de código. Uno de esos proyectos se creó después del corte de los datos de entrenamiento del modelo, según el investigador.
Cloudflare amplió la memoria disponible y corrigió el motor para devolver un error cuando una solicitud debía rechazarse. Antes de reabrir el acceso, comprobó los cambios con el procedimiento de reproducción del investigador y con pruebas propias que incorporaban marcadores para detectar mezclas entre consultas.
El trabajo con SGLang también incorporó controles sobre la reutilización de memoria durante transferencias interrumpidas. Las correcciones buscan impedir que una tarea escriba en espacios ya asignados a otra. El equipo publicó los cambios en el proyecto abierto y detalló las actualizaciones para quienes operan este tipo de infraestructura.