Google DeepMind presentó SynthID Bio, una familia de técnicas que incorpora marcas de agua en proteínas diseñadas con Inteligencia Artificial y en estructuras moleculares predichas. El sistema busca identificar el origen de los diseños sin alterar su función biológica ni la precisión de las predicciones.
La propuesta extiende SynthID, utilizado para identificar contenido digital generado con IA, a la biología sintética. En este campo, los investigadores emplean modelos para generar secuencias de aminoácidos, las unidades que forman las proteínas, o calcular cómo se organizan en el espacio.
El equipo probó proteínas diseñadas para adherirse a tres objetivos biológicos. Las versiones marcadas conservaron una capacidad de unión comparable a las versiones sin marca. El trabajo, publicado en Nature, constituye una prueba de concepto de identificación del origen compatible con la función de los diseños evaluados.
“SynthID Bio es una pieza importante del rompecabezas para rastrear el origen de los diseños biológicos”, señaló Sarah Carter, experta en políticas de bioseguridad y responsable de Science Policy Consulting, en el anuncio de Google DeepMind.
Cómo SynthID Bio incorpora la marca en secuencias y estructuras
La variante para secuencias utiliza ProteinMPNN, un modelo que propone aminoácidos a partir de una estructura de proteína. Durante la generación, una clave secreta favorece determinadas elecciones y distribuye una señal estadística a lo largo de la secuencia. Esa clave permite comprobar posteriormente la presencia de la marca.
Los ensayos de laboratorio incluyeron proteínas que se unen al factor de crecimiento endotelial vascular A, relacionado con la formación de vasos sanguíneos; a PD-L1, una proteína vinculada con la respuesta inmunitaria; y a una región de la proteína de la espícula del SARS-CoV-2.
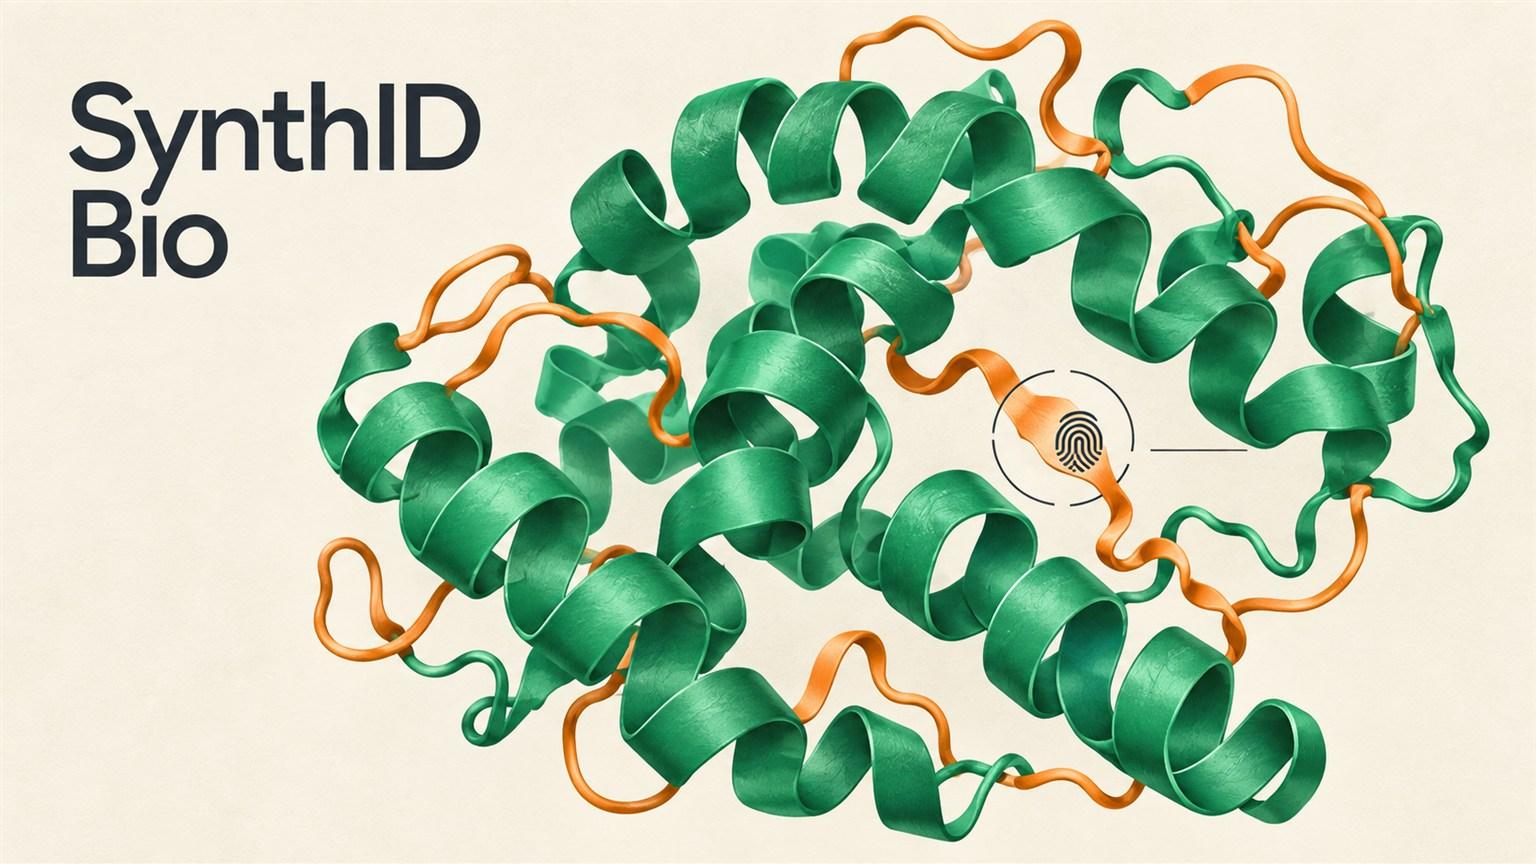
La variante para estructuras utiliza una versión ajustada de AlphaFold 3, el modelo de predicción molecular de DeepMind. Introduce pequeñas modificaciones en las coordenadas de los átomos del archivo digital. En las evaluaciones conservó la precisión estructural y permitió detectar la marca incluso tras añadir ruido o realizar cambios menores.
La detección depende de analizar la señal estadística y establecer un umbral. Las proteínas demasiado cortas pueden contener una señal insuficiente, y añadir segmentos sin marca puede diluirla. La longitud y la modificación de una secuencia afectan la intensidad de la señal detectada.
Código abierto y datos de laboratorio para ampliar la investigación
DeepMind publicó en GitHub el código de la variante para secuencias y los datos de validación en laboratorio. El repositorio incluye resultados de unión y gráficos de comportamiento para los tres objetivos probados, además de ejemplos para comparar secuencias generadas con y sin marca.
La integración con ProteinMPNN permite activar el marcado mediante opciones de configuración. El código se distribuye bajo la licencia Apache 2.0 y los datos experimentales bajo una licencia de atribución Creative Commons. Los parámetros de AlphaFold 3 mantienen sus propias condiciones de uso, diferenciadas de las del código.
Google plantea aplicar estas señales a la revisión de pedidos de síntesis de ADN y a la identificación de entradas sintéticas en bases científicas. La compañía mantiene como línea de investigación la resistencia a alteraciones deliberadas. Los autores del estudio señalan que su uso operativo también requiere coordinación y estándares comunes entre organizaciones.
Fuentes
Google DeepMind — anuncio de SynthID Bio
Nature — estudio de marcas de agua en proteínas
Google DeepMind — código y datos en GitHub
Ars Technica — funcionamiento y límites