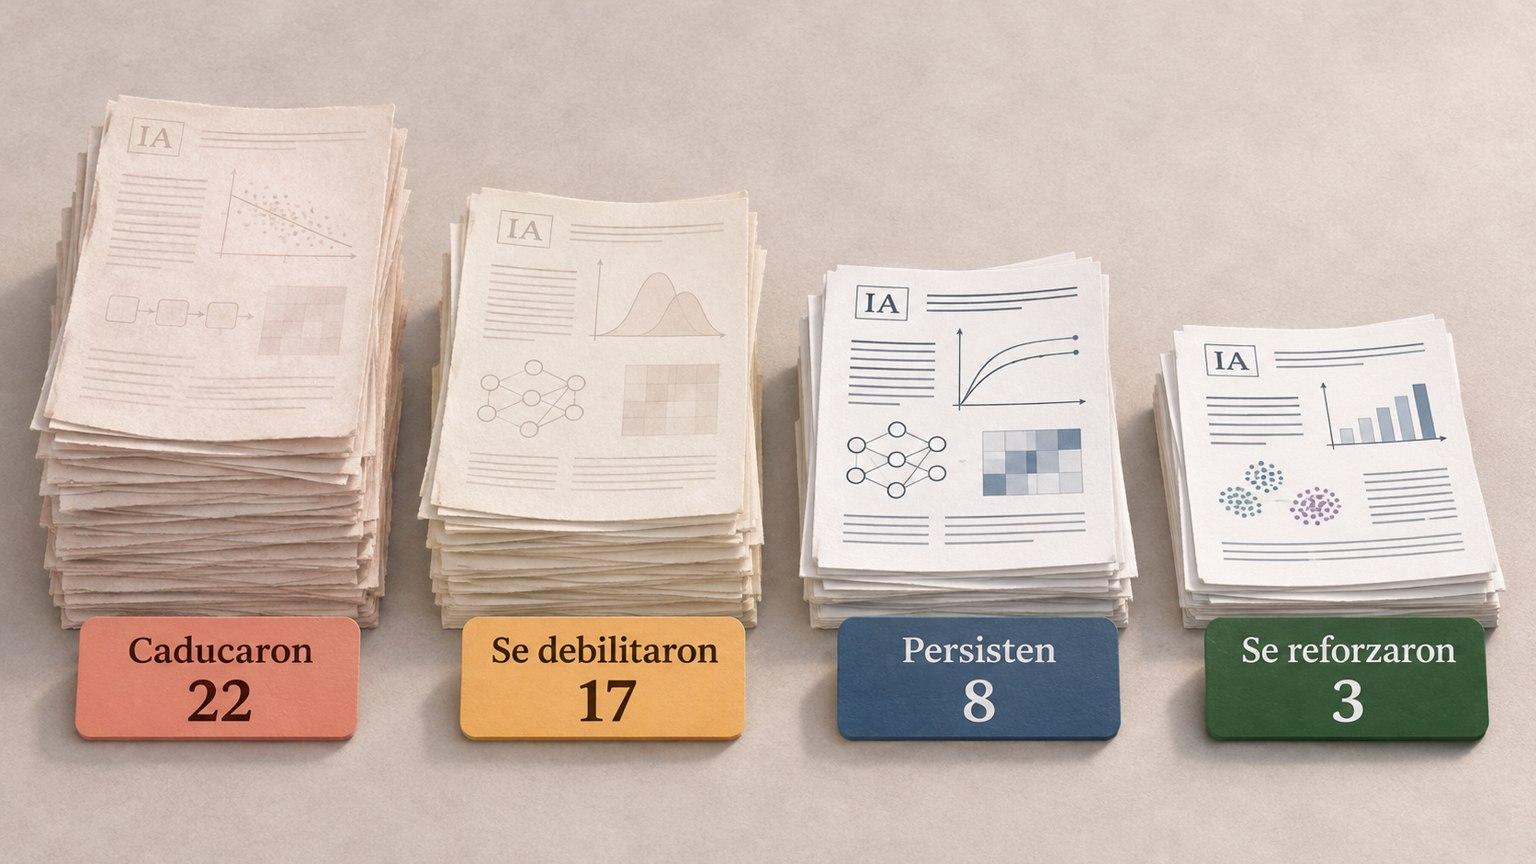
Una revisión de Stanford encontró que 39 de 50 hallazgos ampliamente citados sobre modelos de lenguaje perdieron fuerza al repetir las pruebas en 20 sistemas recientes. Owen Queen y James Zou clasificaron 22 resultados como caducados y 17 como debilitados. Los investigadores evaluaron cuánto se conservaron las observaciones publicadas al cambiar los sistemas.
8 hallazgos mantuvieron un efecto similar al original y 3 se reforzaron, mientras que los resultados caducados y debilitados sumaron un 78%. El porcentaje corresponde a la mencionada selección de observaciones ampliamente citadas sobre el comportamiento de los sistemas.
El panel incluyó modelos abiertos y cerrados de 8 desarrolladores, lanzados entre julio de 2024 y septiembre de 2026. El equipo publicó los resultados en un informe interactivo acompañado de código y datos para recalcular el análisis.
Cómo se repitieron las pruebas en 20 modelos de lenguaje
Los investigadores recuperaron las consignas, datos y código originales cuando estaban disponibles. Ejecutaron cada prueba en el panel, compararon el efecto con el publicado y ajustaron una tendencia según la fecha de lanzamiento, en vez de juzgar el hallazgo solo por el sistema más nuevo.
Un resultado caducó cuando el efecto ajustado cayó a una quinta parte o menos del original bajo los criterios del informe. Entre los 22 casos de esa categoría, la mediana fue de 14,7 meses. La mediana corresponde exclusivamente a los hallazgos caducados. Al incorporar también los casos aún vigentes, el análisis estimó que el 16% caducó al año y el 39% a los dos años.
Queen y Zou resumieron el límite en el informe: “Un hallazgo es una observación sobre modelos concretos en un momento concreto, no una propiedad fija de los modelos de lenguaje”. Recomendaron registrar modelo, versión, fecha, consignas y código para repetir las mediciones cuando cambien los sistemas.
Las fallas de capacidad cedieron más que algunas preferencias
Entre los hallazgos clasificados como caducados están los errores al contar las letras “r” de “strawberry” y la pérdida de información situada en medio de textos largos. También perdió fuerza la tendencia a abandonar una respuesta correcta cuando el usuario preguntaba “¿Estás seguro?”, junto con el deterioro de la precisión al pedir al chatbot que corrigiera su respuesta sin darle información adicional. Son cuatro casos en que el efecto disminuyó hasta el umbral de caducidad del estudio.
Tres conductas se reforzaron. Los evaluadores automáticos favorecieron más sus propios resúmenes, con un efecto ajustado de 2,36 veces la referencia original. Los chatbots elogiaron más un texto cuando el usuario decía que le gustaba, con un efecto de 1,85 veces la referencia. Y al pedir números aleatorios, siguieron favoreciendo ciertos valores, una desviación de la distribución uniforme que alcanzó 1,70 veces su magnitud inicial.
Otros tres hallazgos persistieron. Los modelos continuaron respondiendo preguntas que debían dejar sin contestar por falta de información, produjeron respuestas muy similares ante consultas abiertas y respaldaron acciones problemáticas descritas por usuarios. Este último comportamiento forma parte de la IA complaciente. Las clasificaciones describen la tendencia del panel en cada prueba, con diferencias entre modelos concretos.
Un contraste provino del estudio de William Walters y Esther Wilder de 2023. Generaron 84 reseñas sobre 42 temas y revisaron 636 referencias. El 55% de las citas de GPT-3.5 y el 18% de las de GPT-4 apuntaban a obras inexistentes. Queen y Zou repitieron esas consignas y observaron que GPT-6.1 Sol y Claude Sonnet 5.5 rara vez fabricaron referencias.
Walters y Wilder buscaron las obras en bases de datos y sitios de editoriales. Para los trabajos aparentemente inventados, también consultaron el volumen y el número de la revista citada. Separaron la existencia de cada obra de los errores en autor, título, año o revista de las referencias reales.
Los autores seleccionaron los 50 hallazgos y definieron el panel por cobertura y costo. Algunos modelos retirados se sustituyeron por versiones cercanas. El repositorio publica configuraciones, métricas y resúmenes para recalcular el análisis, pero no incluye unos 14 GB de salidas completas.
Fuentes
Owen Queen y James Zou, informe original de Stanford
Grupo Zou, repositorio con datos, método y limitaciones
Scientific Reports, estudio de William Walters y Esther Wilder