Kareus y Perseus, dos herramientas desarrolladas en la Universidad de Michigan, permiten reducir hasta un 50% la energía utilizada para entrenar modelos de Inteligencia Artificial, según informó la institución. Nvidia evalúa cómo incorporar este enfoque en Megatron-LM, su plataforma de código abierto para entrenar grandes modelos de lenguaje.
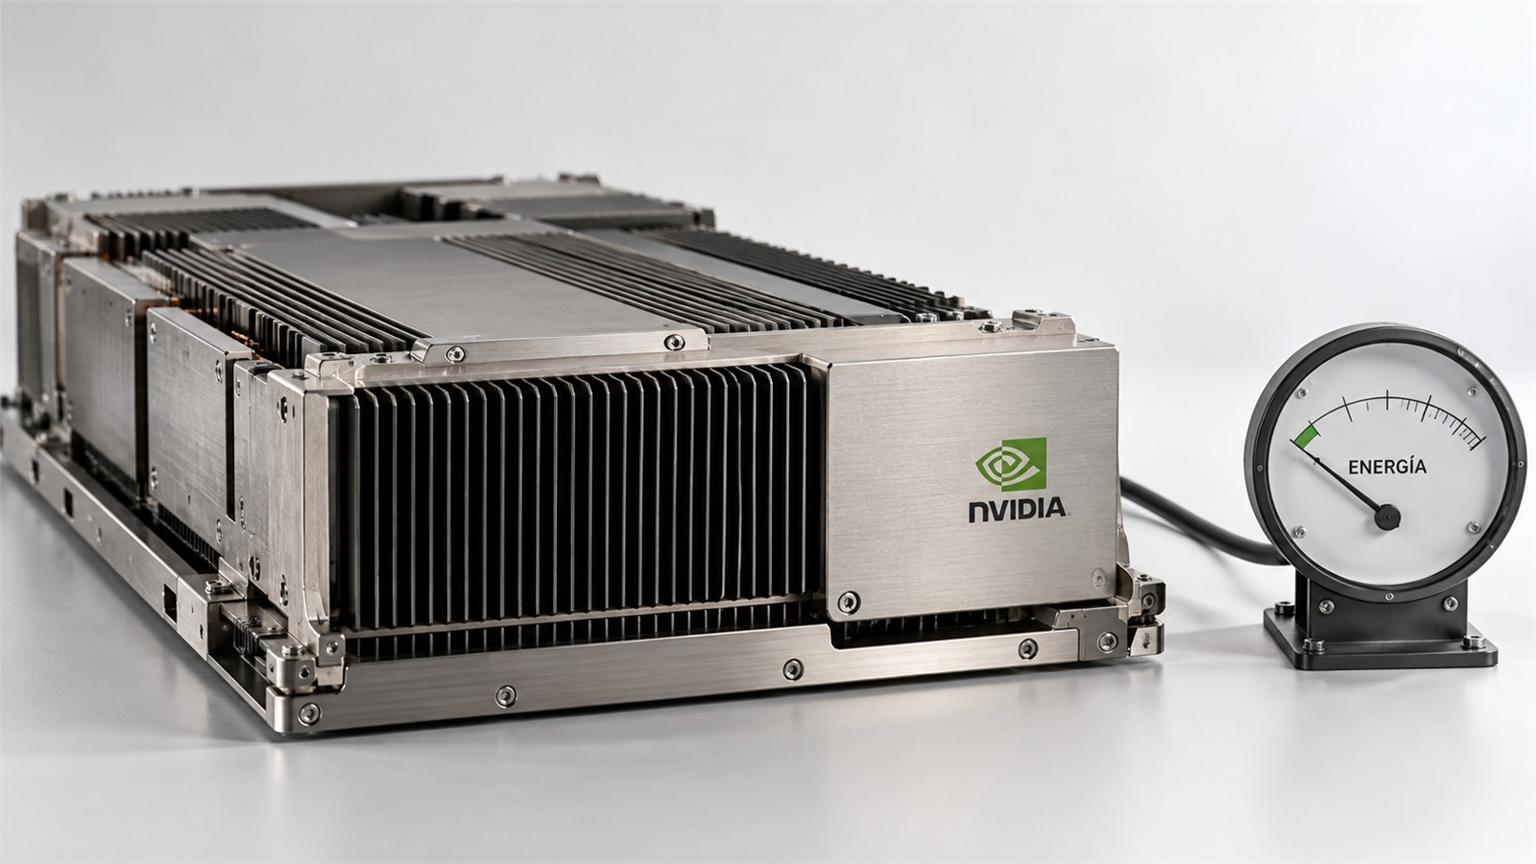
El ahorro proviene de coordinar mejor la velocidad de los procesadores y el orden de las tareas. El equipo plantea que ambas herramientas pueden acercarse a una reducción combinada de entre 40% y 50% en modelos de gran escala, manteniendo el tiempo de entrenamiento y el desempeño.
“Podemos lograr la misma velocidad y desempeño de entrenamiento usando menos energía”, dijo Ruofan Wu, investigadora doctoral en computación e ingeniería, en el comunicado universitario. Wu trabajó durante el verano en la integración del software con Megatron-LM.
Kareus coordina tareas y Perseus ajusta la velocidad
El entrenamiento distribuye los cálculos entre GPU (Graphics Processing Unit, unidad de procesamiento gráfico), chips especializados en ejecutar muchas operaciones simultáneas. Cuando algunas terminan antes, deben esperar a las que tienen más trabajo. Ejecutarlas todas a máxima velocidad consume energía sin adelantar el final del proceso.
Perseus identifica la cadena de tareas que determina la duración total y baja la velocidad de los procesadores que disponen de margen. Así reduce el consumo de los chips que acabarían antes y permanecerían esperando. La herramienta registró ahorros de hasta 30% y está disponible como parte de Zeus, un proyecto abierto de medición y optimización energética.
Kareus añade una coordinación más detallada dentro de cada GPU. Ajusta cuándo comienzan las comunicaciones entre chips, cuántos recursos reciben y cómo se superponen con los cálculos. El estudio distingue la energía consumida al realizar operaciones de la que el hardware necesita incluso cuando no está ejecutando trabajo útil.
Frente a Perseus, el estudio de Kareus registró hasta 28,3% menos energía con el mismo tiempo de entrenamiento, o hasta 27,5% menos tiempo con el mismo presupuesto energético. Son dos comparaciones distintas. La combinación de herramientas busca mejorar ambos componentes del consumo mediante ajustes que dependen de cada carga.
Las pruebas y el trabajo de integración con Nvidia
La investigación evaluó 14 cargas, incluidas pruebas reales con Llama 3.2 de 3.000 millones de parámetros y Qwen 3 de 1.700 millones. También realizó una emulación a mayor escala con Llama 3.3 de 70.000 millones. Los parámetros son los valores ajustados durante el entrenamiento; estas evaluaciones separan los experimentos físicos de la proyección de cargas más grandes.
El repositorio público permite reproducir los resultados con dos equipos y 16 GPU Nvidia A100 de 40 GB en total. Incluye versiones adaptadas de las bibliotecas de entrenamiento, instrucciones y configuraciones de prueba. Su uso requiere preparar ese entorno técnico; los valores de frecuencia y consumo deben ajustarse cuando se emplean otros chips.
Nvidia explicó en su blog técnico que trabaja con el equipo ML.ENERGY de Michigan para medir el consumo en distintas fases y orientar ajustes de velocidad, potencia y planificación. Esa colaboración apunta a ampliar las optimizaciones en Megatron-LM, una base que las empresas pueden adaptar para sus propios sistemas de entrenamiento.
Fuentes
- Universidad de Michigan, ahorro energético y trabajo con Nvidia
- USENIX, estudio de Kareus y presentación oficial
- Nvidia, optimización energética del entrenamiento
- Equipo ML.ENERGY, código y condiciones de reproducción
- Estudio de Kareus, metodología y resultados completos
- Universidad de Michigan, funcionamiento de Perseus